데이터베이스 샤딩의 개념과 전략
들어가며
서비스가 성장하면서 가장 먼저 병목이 발생하는 지점 중 하나는 데이터베이스다.
초기에는 단일 데이터베이스만으로 충분하지만, 트래픽과 데이터 양이 일정 수준을 넘어서면 확장 전략을 고민해야 한다.
이 글에서는 데이터베이스 확장 전략의 흐름을 짚어보고,
그중에서도 최후의 선택지로 자주 언급되는 샤딩(Sharding)의 개념과 대표적인 전략을 정리해본다.
데이터베이스 샤딩이란?
샤딩(Sharding) 이란 하나의 데이터베이스에 모든 데이터를 저장하는 대신,
데이터를 여러 데이터베이스로 수평 분할(horizontal partitioning)하여 저장하는 방식이다.
즉,
- 단일 DB → X
- 여러 개의 독립된 DB → O 각 DB가 전체 데이터의 일부(shard)만을 책임진다.
샤딩의 핵심 목적은 다음과 같다.
- 데이터 증가에 따른 저장 용량 한계 해결
- 트래픽 분산을 통한 성능 향상
- 단일 장애 지점(SPOF) 완화
왜 샤딩이 필요한가?
DB 트래픽을 감당하기 위해 일반적으로 아래 두 가지 확장 전략을 고려한다.
1. 스케일 업
- CPU, RAM, Disk 성능을 높이는 방식
- 구조 변경 없이 빠르게 적용 가능
하지만 단점이 명확하다.
- 비용이 기하급수적으로 증가
- 하드웨어 성능에는 물리적 한계가 존재
- 어느 순간부터 돈으로 해결되지 않는 구간에 도달
2. 스케일 아웃
- 서버 수를 늘려 부하를 분산
- 분산 처리 기반의 확장 전략
샤딩은 이 스케일 아웃 전략의 최종 단계에 해당한다.
데이터베이스 확장 전략의 단계적 흐름
실무에서는 보통 아래와 같은 순서로 확장을 검토한다.
- 단일 DB
- Index 튜닝
- Partitioning
- Read Replica
- Sharding
단계가 올라갈수록 다음 비용이 증가한다.
- 시스템 복잡도
- 운영 및 장애 대응 비용
- 개발 난이도
즉, 샤딩은 가장 마지막에 고려해야 할 전략이다.
Read Replica와 Partitioning까지 적용했음에도 트래픽을 감당하지 못하는 경우에만 선택하는 것이 일반적이다.
이 글에서는 그런 극단적인 상황에서 사용되는 샤딩 전략에 집중해본다.
샤딩의 대표적인 종류
샤딩은 데이터를 어떤 기준으로 나눌 것인가에 따라 여러 방식으로 나뉜다.
그중 가장 기본적인 두 가지는 다음과 같다.
- 모듈러 샤딩 (Modular Sharding)
- 레인지 샤딩 (Range Sharding)
모듈러 샤딩 (Modular Sharding)
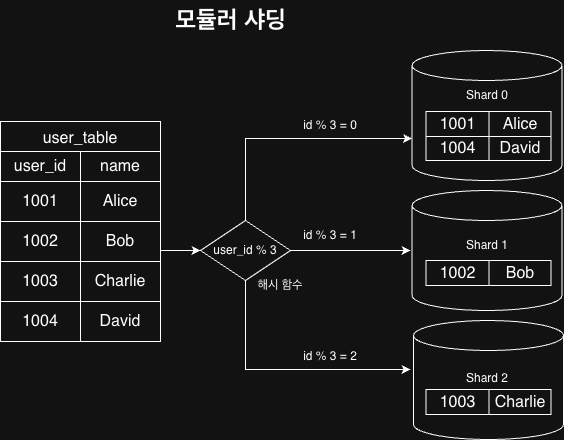
모듈러 샤딩은 특정 키(PK 등)에 대해 나머지 연산을 적용하여 샤드를 결정하는 방식이다. 그림처럼 해시함수를 통해 테이브을 여러 디비로 분산시킨다. 해시함수는 pk % DB의 수로 나누어진다.
예시
1
shard_id = user_id % N
- user_id가 1이면 → shard 1
- user_id가 2이면 → shard 2
- …
- N은 샤드 개수
그렇다면 실제 프로젝트에선 어떻게 적용할 수 있을까? 일단 N개의 디비를 설정해야하고, 각각의 디비로 라우팅해야하며,
Spring의 간단한 CRUD에 샤딩을 추가해보자.
- 샤드키를 담아둘 컨텍스트
1
2
3
4
5
6
7
8
9
10
// ShardContext.java
public final class ShardContext {
 private static final ThreadLocal<Long> SHARD_KEY = new ThreadLocal<>();

 private ShardContext() {}

 public static void setShardKey(Long shardKey) { SHARD_KEY.set(shardKey); }
 public static Long getShardKey() { return SHARD_KEY.get(); }
 public static void clear() { SHARD_KEY.remove(); }
}
- 라우팅 DataSource
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
// ShardRoutingDataSource.java
public class ShardRoutingDataSource extends AbstractRoutingDataSource {

 private final int shardCount;

 public ShardRoutingDataSource(int shardCount) {
     this.shardCount = shardCount;
 }

 @Override
 protected Object determineCurrentLookupKey() {
     Long key = ShardContext.getShardKey();
     if (key == null) {
         // 샤드키 없으면 기본 샤드로 (예외)
         return "shard0";
     }
     long shardId = key % shardCount;
     return "shard" + shardId; // shard0, shard1, shard2 ...
 }
}
- DataSource 설정 (샤드별 DS + Routing DS)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
@Configuration
@EnableJpaRepositories(
     basePackages = "com.example.user", // 기존 레포지토리 패키지
     entityManagerFactoryRef = "entityManagerFactory",
     transactionManagerRef = "transactionManager"
)
public class DataSourceConfig {

 private static final int SHARD_COUNT = 3;

 @Bean
 public DataSource shard0() { return hikari("jdbc:mysql://db0:3306/app"); }

 @Bean
 public DataSource shard1() { return hikari("jdbc:mysql://db1:3306/app"); }

 @Bean
 public DataSource shard2() { return hikari("jdbc:mysql://db2:3306/app"); }

 private DataSource hikari(String jdbcUrl) {
     HikariDataSource ds = new HikariDataSource();
     ds.setJdbcUrl(jdbcUrl);
     ds.setUsername("app");
     ds.setPassword("password");
     // pool size는 샤드 수 고려해서 작게 가져가는 편이 안전
     ds.setMaximumPoolSize(10);
     return ds;
 }

 @Bean
 public DataSource routingDataSource(
         @Qualifier("shard0") DataSource shard0,
         @Qualifier("shard1") DataSource shard1,
         @Qualifier("shard2") DataSource shard2
 ) {
     Map<Object, Object> targets = new HashMap<>();
     targets.put("shard0", shard0);
     targets.put("shard1", shard1);
     targets.put("shard2", shard2);

     ShardRoutingDataSource routing = new ShardRoutingDataSource(SHARD_COUNT);
     routing.setTargetDataSources(targets);
     routing.setDefaultTargetDataSource(shard0);
     routing.afterPropertiesSet();

     // 트랜잭션 시작 시 커넥션이 먼저 잡히지 않게 지연 프록시 > 샤드를 먼저 잡고 커넥션 연결
     return new LazyConnectionDataSourceProxy(routing);
 }

 @Bean
 public LocalContainerEntityManagerFactoryBean entityManagerFactory(
         EntityManagerFactoryBuilder builder,
         @Qualifier("routingDataSource") DataSource routingDataSource
 ) {
     return builder
             .dataSource(routingDataSource)
             .packages("com.example.user") // 엔티티 패키지
             .build();
 }

 @Bean
 public PlatformTransactionManager transactionManager(
         @Qualifier("entityManagerFactory") LocalContainerEntityManagerFactoryBean emf
 ) {
     return new JpaTransactionManager(Objects.requireNonNull(emf.getObject()));
 }
}
여러 개의 DB 커넥션을 하나로 묶어 관리하기 위해 DataSourceConfig를 구성한다.
단일 DB 환경에서는 application.yml(또는 properties)을 통해 하나의 커넥션만 설정하면 충분하지만, 샤딩 환경에서는 샤드 수만큼 서로 다른 DB 커넥션을 동시에 관리해야 한다. 이를 위해 여러 DataSource를 조합할 수 있는 별도의 설정 계층이 필요하다.
스프링의 관점에서 보면, Spring/JPA는 DataSource 인터페이스만 알고 있으면 되고, 실제 커넥션 풀의 구현체는 언제든 교체 가능한 구조로 설계되어 있다. 즉, 인프라 구현은 숨긴 채 애플리케이션은 동일한 방식으로 DB에 접근할 수 있다.
현재 코드에서는 각 샤드별 커넥션 풀로 HikariCP 구현체를 사용하고, 이를 RoutingDataSource로 묶어 요청마다 적절한 샤드의 DB로 라우팅하도록 구성하였다.
- “어떤 샤드를 쓸지” 서비스 레벨에서 지정
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
// UserService.java
@Service
public class UserService {
    private final UserRepository userRepository;
    public UserService(UserRepository userRepository) {
        this.userRepository = userRepository;
    }

    @Transactional
    public User createUser(Long userId, String name) {
        ShardContext.setShardKey(userId);
        try {
            return userRepository.save(new User(userId, name));
        } finally {
            ShardContext.clear();
        }
    }

    @Transactional(readOnly = true)
    public User getUser(Long userId) {
        ShardContext.setShardKey(userId);
        try {
            return userRepository.findById(userId)
                    .orElseThrow(() -> new RuntimeException("not found"));
        } finally {
            ShardContext.clear();
        }
    }
}
장점
- 구현이 단순함
- 데이터 분산이 비교적 균등함
단점
- 샤드 개수 변경이 거의 불가능
- 샤드 추가 시 전체 데이터 재배치 및 리팩터링 필요
- 운영 중 확장에 매우 취약
즉, 초기 설계 실수 시 되돌리기 어려운 방식으로 견고한 설계가 필요하다.
레인지 샤딩 (Range Sharding)
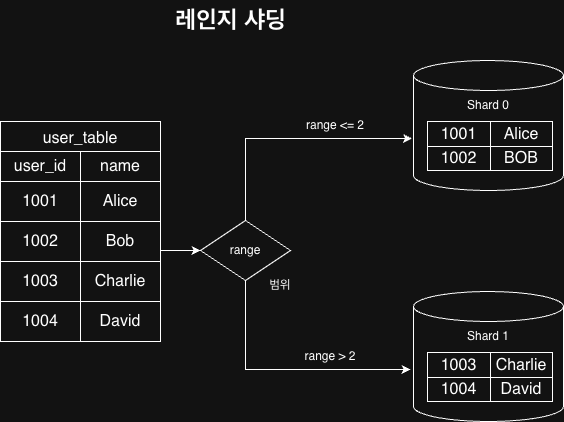
레인지 샤딩은 특정 컬럼의 값 범위(range)를 기준으로 샤드를 나누는 방식이다.
예시
- shard 1: user_id 1 ~ 1,000,000
- shard 2: user_id 1,000,001 ~ 2,000,000
또는
- 날짜 기준 (월/년 단위)
- 지역 기준
- 비즈니스 도메인 기준
위의 모듈러 코드에서 간단하게 라우팅 코드만 바꿔 로직을 수정할 수 있다.
기존코드
1
2
long shardId = key % shardCount;
return "shard" + shardId;
rnage-sharding
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
// RangeShardRouter.java (샤드 결정 로직만 분리)
public class RangeShardRouter {

    private final List<RangeRule> rules;

    public RangeShardRouter(List<RangeRule> rules) {
        this.rules = rules;
    }

    public String route(long userId) {
        return rules.stream()
                .filter(r -> r.matches(userId))
                .findFirst()
                .orElseThrow(() -> new IllegalStateException("No shard range rule for key=" + userId))
                .shardName();
    }

    public record RangeRule(long startInclusive, long endInclusive, String shardName) {
        public boolean matches(long v) {
            return v >= startInclusive && v <= endInclusive;
        }
    }
}
이전 모듈러 코드의 ShardRoutingDataSource의 오버라이딩 부분만 갈아 끼우면 된다.
1
2
3
4
5
6
7
8
@Override
protected Object determineCurrentLookupKey() {
    Long key = ShardContext.getShardKey();
    if (key == null) return "shard0";

    return rangeShardRouter.route(key); // 여기만 모듈러 → 레인지로 변경
}
장점
- 특정 범위 쿼리에 유리
- 샤드 확장 전략이 비교적 명확
단점
- 데이터 쏠림(Hot Spot) 발생 가능
- 특정 샤드에 트래픽 집중 위험
데이터 분포 예측이 매우 중요하다.
예를 들어, 레인지 샤딩을 사용해 user_id 기준으로 1 ~ 1000, 1001 ~ 2000 과 같이 샤드를 나눴다고 가정해보자.
만약 1 ~ 1000 구간에 제니, 지디처럼 트래픽을 많이 유발하는 유명 인사 계정이 몰려 있고,
1001 이후에는 상대적으로 활동량이나 조회 빈도가 낮은 일반 사용자 계정이 주로 존재한다면,
샤드 간 트래픽 분포는 급격히 불균형해진다.
이 경우, 1 ~ 1000 범위를 담당하는 특정 샤드는
조회 요청, 캐시 미스, DB 커넥션 사용량이 급증하며 병목이 발생하고
반면 다른 샤드들은 자원이 여유 있음에도 제대로 활용되지 않는 상황이 된다.
즉, 논리적으로는 동일한 크기의 데이터 범위를 나눴지만,
실제 트래픽 관점에서는 특정 샤드에 부하가 집중되는 Hot Spot 문제가 발생한다.
이러한 문제는 단순히 샤드 수를 늘리는 것만으로는 해결되지 않으며,
샤딩 키의 특성과 데이터 사용 패턴을 사전에 충분히 예측하지 않으면
오히려 샤딩이 새로운 병목 지점을 만들어낼 수 있다.
Moudlar VS Range 정리하자면
모듈러 샤딩은 샤드 결정이 계산 한 줄로 끝난다. (userId % N)
반면 레인지 샤딩은 샤드 결정이 “규칙 기반”이다. 즉, 키가 어느 범위에 속하는지 판단하기 위한 range 룰(매핑 테이블) 이 필요하다.
따라서 스프링 코드 관점에서 바뀌는 지점은 AbstractRoutingDataSource.determineCurrentLookupKey() 내부의 샤드 선택 로직뿐이며, 나머지(DataSource 구성, ThreadLocal 컨텍스트, 서비스에서 shardKey 지정)는 동일하게 재사용할 수 있다.
여러대의 DB 인스턴스 vs 단일 DB의 여러 스키마
여기서 의문점이 생겼다. 처음엔 당연히 여러대의 DB 컨테이너를 띄워야 하지 않을까 라고 생각했다.
하지만, 하나의 도커 컨테이너에 여러 스키마를 띄우는건 비효율적일까?
정답은, “여러대의 DB 컨테이너를 띄워야 한다.” 라는 글이 있던데,
사실 편의용으로는 가능하지만 샤딩은 물리적으로 분리된 데이터베이스를 전재로 하기때문에, 논리적 샤딩과 맞지않는다.
근거는 다음과 같다. 하나의 컨테이너에 여러 스키마를 띄우게 될 경우
- 커넥션, 락, I/O 모두 공유된다.
- 장애 테스가 의미가 없어진다. 즉, 샤딩했다는 착각만 생긴다. 왜냐면, 디비 인스턴스는 하나일 뿐이다.
샤딩 도입 전 반드시 고려할 점
샤딩은 만능 해결책이 아니다. 오히려 다음과 같은 부담을 동반한다.
- Cross-shard JOIN 불가능
- 트랜잭션 처리 복잡도 증가
- 애플리케이션 레벨에서 라우팅 로직 필요
- 운영/모니터링 난이도 급상승
따라서 다음 질문에 모두 YES인 경우에만 샤딩을 고려하는 것이 좋다.
- 단일 DB 성능 튜닝이 한계에 도달했는가?
- Read Replica로도 트래픽을 감당할 수 없는가?
- 데이터 증가 속도가 예측 가능한가?
- 운영 복잡도를 감당할 수 있는 조직인가?
마치며
샤딩은 데이터베이스 확장의 끝판왕에 가깝다.
잘 설계하면 강력하지만, 잘못 도입하면 기술 부채가 된다.