Virtual Thread — JDK 21이 바꾼 자바 동시성 모델
1. Virtual Thread 개요
왜 등장했는가
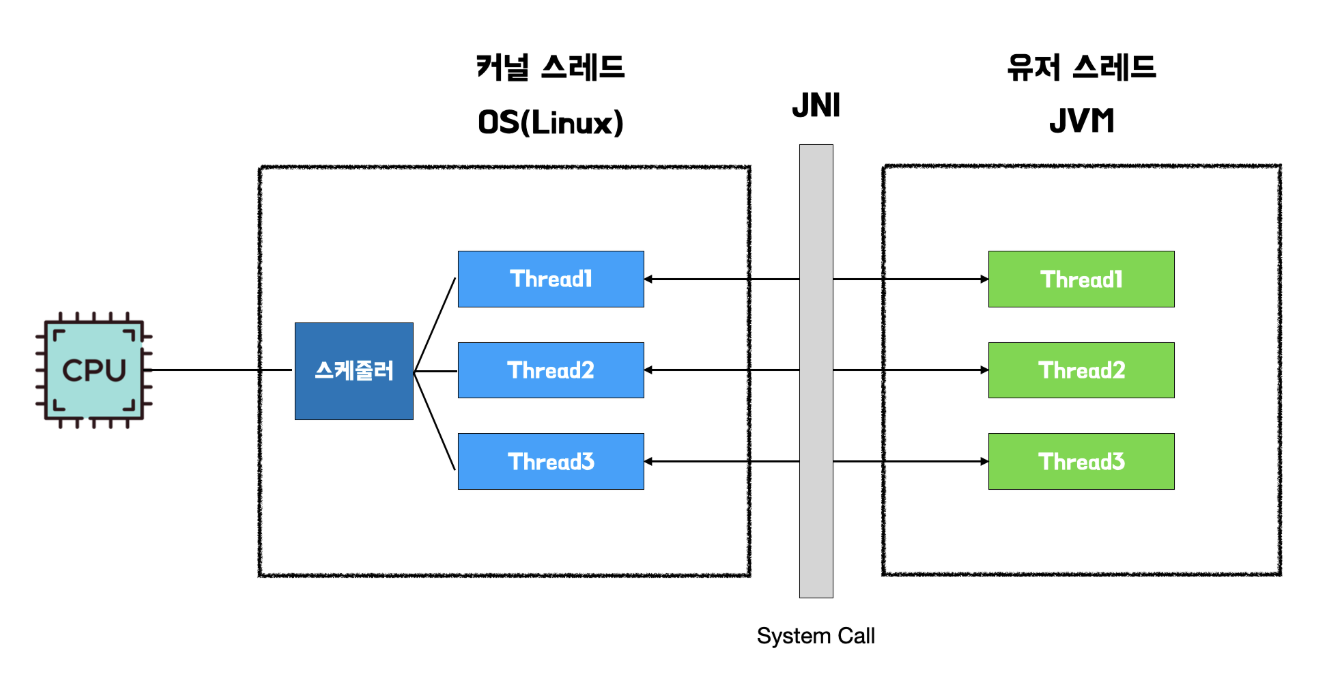
기존 자바의 스레드 모델은 OS 스레드와 1:1로 매핑되는 플랫폼 스레드(Platform Thread) 기반이다. 이 구조에서 스레드 하나를 만들면 OS 수준의 스택 메모리(기본 약 1MB)가 할당되고, 컨텍스트 스위칭 비용도 OS 레벨에서 발생한다.
(기본 java thread 구조)
결과적으로 동시에 수천~수만 개의 요청을 처리해야 하는 서버 애플리케이션에서 스레드를 무한정 늘리는 건 불가능하다. 그래서 스레드 풀로 스레드 수를 제한하고 재사용하는 방식이 표준이 되었는데, 이 방식은 사실상 “처리량의 상한 = 스레드 풀 크기”라는 한계를 내포하고 있다.
 출처: 우아한테크블로그
Virtual Thread는 이 구조적 한계를 깨기 위해 JDK 21에서 정식 도입되었다.
참고: JEP 444: Virtual Threads
개념
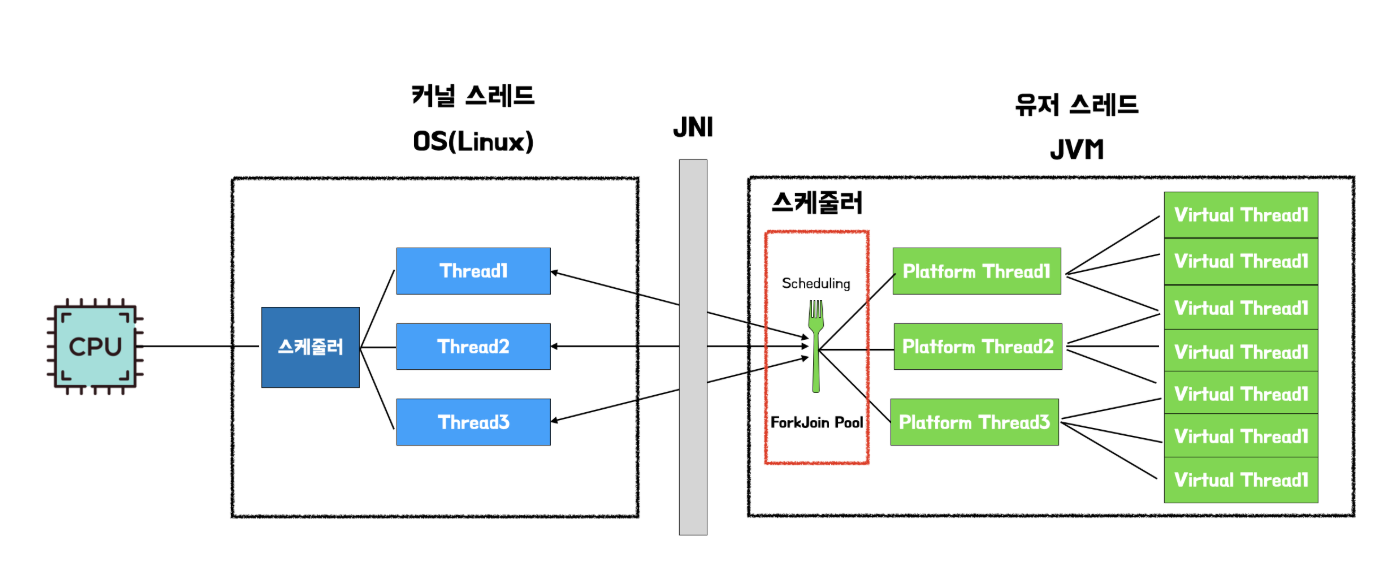
Virtual Thread는 JVM이 관리하는 경량 스레드다. OS 스레드가 아닌 JVM 내부의 스케줄러가 관리하므로, 스택 메모리도 필요한 만큼만 동적으로 할당되고 (수 KB 수준에서 시작), 수백만 개를 생성해도 메모리 부담이 크지 않다.
핵심은 OS 스레드와 1:1이 아니라 M:N 모델이라는 점이다. 다수의 Virtual Thread가 소수의 캐리어 스레드(Carrier Thread, 실제 OS 스레드)에 매핑되어 실행된다.
 출처: 우아한테크블로그
(virtual thread 구조)
동작 원리
1
2
3
4
5
6
Virtual Thread A ──┐
Virtual Thread B ──┼──▶ Carrier Thread 1 (OS Thread)
Virtual Thread C ──┘
Virtual Thread D ──┐
Virtual Thread E ──┼──▶ Carrier Thread 2 (OS Thread)
Virtual Thread F ──┘
- Virtual Thread가 실행되면 JVM의 ForkJoinPool(기본 스케줄러)이 비어있는 캐리어 스레드에 마운트(mount)한다.
- Virtual Thread가 I/O 블로킹 작업(네트워크 호출, 파일 읽기, sleep 등)을 만나면 캐리어 스레드에서 언마운트(unmount)된다.
- 캐리어 스레드는 즉시 다른 Virtual Thread를 마운트하여 실행한다.
- 블로킹이 끝나면 Virtual Thread는 다시 빈 캐리어 스레드에 마운트되어 이어서 실행된다.
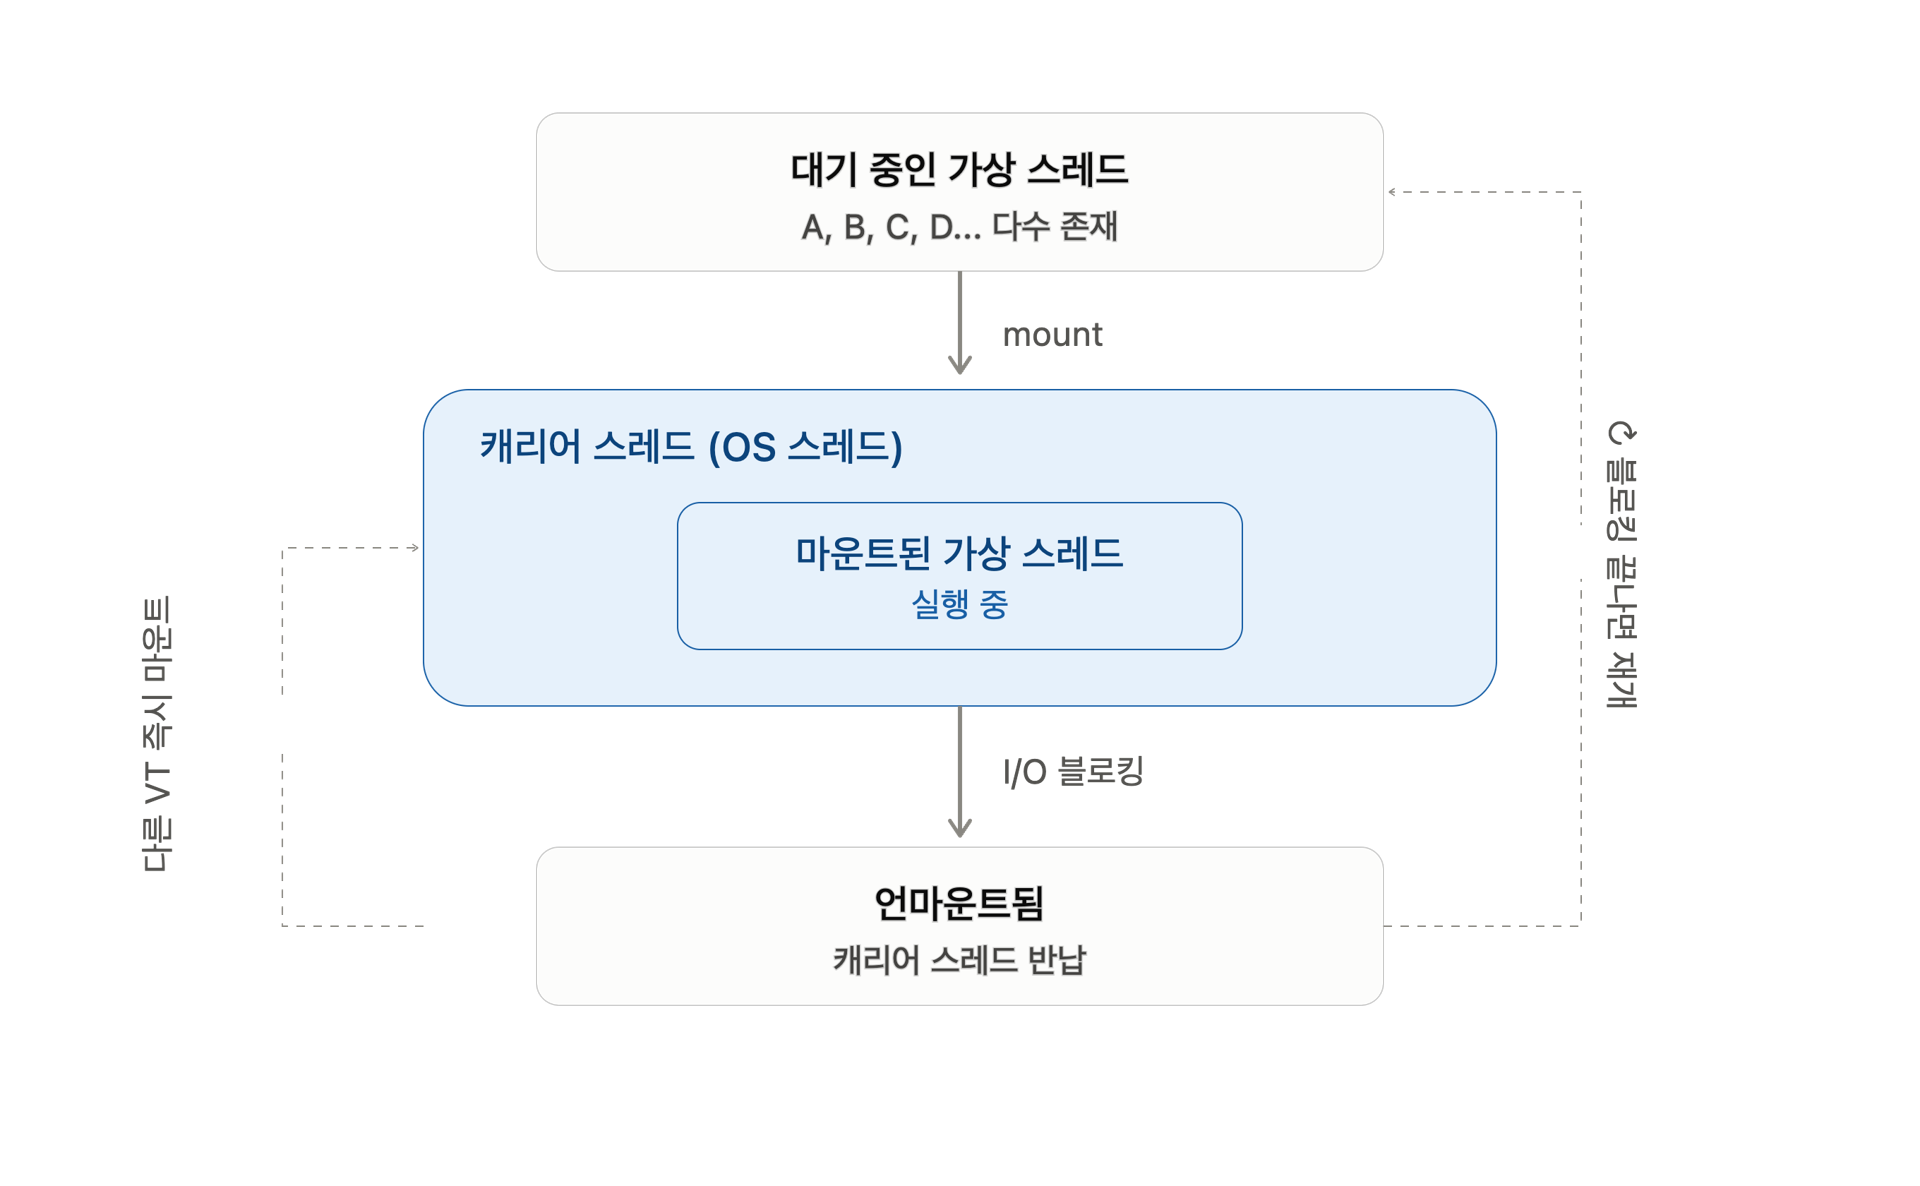
이 마운트/언마운트는 JVM 내부에서 일어나는 동작이므로 OS 컨텍스트 스위칭보다 훨씬 가볍다. 우리 입장에서는 기존과 똑같이 블로킹 코드를 쓰면 되고, 내부적으로 논블로킹처럼 동작하는 것이다.
참고: Inside Java — Virtual Threads: An Adoption Guide
기본 사용법
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;

// 1. 직접 생성
Thread vt = Thread.ofVirtual().start(() -> {
    System.out.println("Hello from virtual thread");
});

// 2. ExecutorService 사용 (가장 일반적인 사용법)
ExecutorService executor = Executors.newVirtualThreadPerTaskExecutor();
try (executor) {
    executor.submit(() -> {
        // 요청마다 새 virtual thread가 생성됨
        return exAPI();
    });
}
Virtual Thread는 기본적으로 데몬 스레드이기 때문에, main 스레드가 먼저 종료되면 실행 중이던 virtual thread도 결과와 상관없이 강제 종료된다. 결과를 기다려야 한다면
.join()으로 명시적으로 완료를 대기해야 한다.
개념에 대한 자세한 설명은 네이버, 우아한테크블로그에 너무나도 잘 설명되어있음
2. Spring Boot에서 Virtual Thread 사용하기
적용 조건
- JDK 21 이상
- Spring Boot 3.2 이상
설정 방법
Spring Boot 3.2부터는 프로퍼티 한 줄로 활성화할 수 있다.
1
2
3
4
5
# application.yml
spring:
  threads:
    virtual:
      enabled: true
이 설정을 켜면 아래 항목들이 자동으로 Virtual Thread 기반으로 전환된다.
- Tomcat/Undertow의 요청 처리 스레드
@Async어노테이션의 기본 실행자- Spring MVC의 비동기 요청 처리
- 스케줄링(
@Scheduled)의 실행 스레드
참고: Spring Boot 3.2 Release Notes — Virtual Threads
내부적으로 무엇이 바뀌는가
기존 Tomcat은 스레드 풀(기본 200개)을 두고 요청을 처리한다. Virtual Thread를 활성화하면 이 스레드 풀 대신 Executors.newVirtualThreadPerTaskExecutor()가 사용된다. 요청마다 새 Virtual Thread가 생성되어 처리되므로 동시 요청 수의 상한이 스레드 풀 크기에 묶이지 않게 된다.
주의: Pinning 이슈
Virtual Thread가 synchronized 블록 안에서 블로킹 I/O를 수행하면, 캐리어 스레드에서 언마운트되지 못하고 고정(pin)되어 버린다. 이 상태에서는 플랫폼 스레드를 점유한 채 블로킹되므로 Virtual Thread의 장점이 사라진다.
- 원래 기대: Virtual Thread만 멈추고 Carrier Thread는 반납
- 실제(JDK 21~23): Virtual Thread와 Carrier Thread가 함께 멈춤
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
// Pinning이 발생하는 코드
synchronized (lock) {
    // 블로킹 I/O — 이 순간 캐리어 스레드가 pin됨
    String result = restTemplate.getForObject(url, String.class);
}

// 해결: ReentrantLock 사용
private final ReentrantLock lock = new ReentrantLock();

lock.lock();
try {
    String result = restTemplate.getForObject(url, String.class);
} finally {
    lock.unlock();
}
Spring Framework 6.1부터는 내부 코드의 synchronized를 ReentrantLock으로 대체하는 작업이 진행되었다. 다만 서드파티 라이브러리(JDBC 드라이버, 커넥션 풀 등)에서 여전히 synchronized를 사용하는 경우가 있으므로 확인이 필요하다. (스프링 부트 3.x 버전에서 사용이 어려운 가장 큰 이유 아닐까?)
참고: Spring Framework — ReentrantLock 전환 이슈
Pinning 감지를 위해 JVM 옵션을 사용할 수 있다.
1
2
3
4
# JDK 21
-Djdk.tracePinnedThreads=full

# JDK 24부터는 JFR(Java Flight Recorder) 이벤트로 통합됨
참고: JEP 491: Synchronize Virtual Threads without Pinning (JDK 24)
JDK 24부터는 synchronized 내부에서도 pinning 없이 언마운트가 가능하도록 개선되었다. JDK 21~23을 사용하는 경우에만 이 이슈에 주의하면 된다고함.
3. Virtual Thread를 스레드 풀로 쓰면 안 되는 이유
스레드 풀의 존재 이유를 되짚어 보자
기존에 스레드 풀을 쓰는 이유는 두 가지다.
- 스레드 생성 비용이 비싸서 재사용하려고
- 스레드 수를 제한하여 시스템 리소스를 보호하려고
Virtual Thread는 이 두 가지 전제를 모두 깨뜨린다.
- 생성 비용이 극히 저렴하다 (OS 스레드 할당 없이 JVM 내부 객체 생성 수준)
- 수백만 개를 만들어도 OS 스레드를 수백만 개 먹지 않는다
따라서 Virtual Thread를 풀에 넣어 재사용하는 것은 “공짜로 만들 수 있는 걸 굳이 빌려 쓰는” 격이다.
풀에 넣으면 오히려 성능이 나빠진다
1
2
// 안티 패턴
ExecutorService pool = Executors.newFixedThreadPool(100, Thread.ofVirtual().factory());
위 코드는 Virtual Thread를 100개로 제한해서 풀링하는데, 이러면 101번째 요청부터 대기하게 된다. Virtual Thread의 핵심 이점인 “요청마다 전용 스레드를 부여하여 동시성을 극대화하는 것”이 사라진다.
“난 가벼워서 필요할때만 만들어서 쓰고싶은데, 왜 미리 만들어두는거야?”
올바른 사용 패턴
1
2
3
4
5
6
7
// 항상 이 패턴을 사용한다
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    // try-with-resources
    List<Future<String>> futures = tasks.stream()
        .map(task -> executor.submit(() -> process(task)))
        .toList();
}
만약 백엔드 리소스(DB 커넥션, 외부 API rate limit 등)를 보호하기 위해 동시 접근 수를 제한해야 한다면, 스레드 풀이 아니라 세마포어로 제어할 수도 있음.
위의 안티패턴은 “어플리케이션 전체의 쓰레드 제한을 걸어버리지만, 세마포어는 특정 작업에만 쓰레드 제한을 두는것임”
1
2
3
4
5
6
7
8
9
10
11
private final Semaphore dbPermits = new Semaphore(50);

void handleRequest() {
    dbPermits.acquire(); // 입장권
    try {
        // DB 작업 — 동시 50개로 제한
        queryDatabase();
    } finally {
        dbPermits.release(); // 입장권 반납
    }
}
참고: Oracle — Virtual Threads (dev.java)
4. Virtual Thread, 무조건 좋을까?
효과가 큰 경우
I/O 바운드 작업이 많은 서버 애플리케이션에서 가장 큰 효과를 발휘한다.
- 외부 API 호출이 빈번한 서비스 (MSA 환경의 서비스 간 통신)
- DB 쿼리 대기 시간이 긴 경우
- 파일 I/O가 많은 배치 처리
- 다수의 클라이언트 요청을 동시에 처리하는 웹 서버
“스레드가 대부분의 시간을 I/O 대기에 쓰는” 워크로드다. 이런 상황에서 Virtual Thread는 대기 시간 동안 캐리어 스레드를 반납하므로 적은 OS 스레드로 훨씬 많은 요청을 동시에 처리할 수 있다.
굳이 필요 없는 경우
CPU 바운드 작업이 주인 경우에는 Virtual Thread가 별 이점이 없다.
- 이미지/영상 인코딩, 암호화 연산 등 CPU를 계속 점유하는 작업
- 복잡한 수학 연산, ML 추론
CPU 바운드 작업은 어차피 캐리어 스레드를 계속 점유해야 하므로 언마운트가 일어나지 않는다. 이 경우 Virtual Thread를 아무리 많이 만들어도 동시에 실행되는 수는 결국 CPU 코어 수에 수렴하므로, 기존 플랫폼 스레드 풀과 성능 차이가 거의 없다.
도입 전 체크리스트
Virtual Thread가 효과적으로 동작하려면 몇 가지 전제 조건이 충족되어야 한다.
- JDK 21 이상이 운영 환경에서 사용 가능한가?
- 사용 중인 라이브러리(JDBC 드라이버, HTTP 클라이언트, 커넥션 풀)가
synchronized블록 내부에서 블로킹 I/O를 하지 않는가? (JDK 24 미만인 경우) - ThreadLocal에 무거운 객체를 캐싱하고 있지 않은가? Virtual Thread는 매번 새로 생성되므로 ThreadLocal 캐싱 전략이 오히려 메모리 낭비가 된다.
- 스레드 수가 곧 동시 접근 수 제한 역할을 하던 코드가 있다면 Semaphore 등으로 교체했는가?
리액티브 프로그래밍(WebFlux)과의 비교
Virtual Thread의 등장으로 “블로킹 코드 스타일로 논블로킹 성능을 얻는다”가 가능해지면서, 기존에 WebFlux(Reactor)를 도입했던 가장 큰 이유 중 하나가 약해졌다. 리액티브는 여전히 backpressure, 스트림 합성 등 고유한 장점이 있지만, 단순히 I/O 동시성을 높이기 위한 목적이라면 Virtual Thread + 전통적인 블로킹 MVC가 코드 가독성과 디버깅 편의성 면에서 유리하다. (WebFlux 구현하는거 보니까 진정으로 효율 보려면 되게 복잡해 보임..)
사실 Virtual Thread랑 WebFlux가 가지는 구조 자체는 너무나도 다르지만, 목표하는 바가 같다고 느껴졌다. Virtual Thread를 쓸 수 있는 환경에서 굳이 WebFlux 를 기용할 필요가 있을까?
(AI 답변) WebFlux를 쓰는게 더 좋을 경우
- 대량의 지속 연결 또는 이벤트 스트리밍
- Backpressure가 비즈니스 요구사항임
- 전체 스택이 논블로킹 드라이버/클라이언트 기반
- 이미 Reactor 생태계에 깊게 투자함
참고: Spring Blog — Embracing Virtual Threads
실습
이번에는 실제 Spring Boot 환경에서 직접 Vittual Thread 를 테스트 해보자! 아래는 테스트용 RestController다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
package com.example.virtualThread;

import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;

import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

import lombok.extern.slf4j.Slf4j;

@Slf4j
@RestController
public class LoadTestController {

    private static final long WORK_MILLIS = 1000L;

    private final ExecutorService virtualThreadExecutor = Executors.newVirtualThreadPerTaskExecutor();

    @GetMapping("/api/normal")
    public String normal() {
        long start = System.currentTimeMillis();
        log.info("[normal] start thread={}", Thread.currentThread());
        sleep();
        long elapsed = System.currentTimeMillis() - start;
        log.info("[normal] end elapsed={}ms", elapsed);
        return "normal done in " + elapsed + "ms";
    }

    @GetMapping("/api/virtual")
    public CompletableFuture<String> virtual() {
        long start = System.currentTimeMillis();
        return CompletableFuture.supplyAsync(() -> {
            log.info("[virtual] start thread={}", Thread.currentThread());
            sleep();
            long elapsed = System.currentTimeMillis() - start;
            log.info("[virtual] end elapsed={}ms", elapsed);
            return "virtual done in " + elapsed + "ms";
        }, virtualThreadExecutor);
    }

    private void sleep() {
        try {
            Thread.sleep(WORK_MILLIS);
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
        }
    }
}
별도의 yml 설정 없이 기본 API 두 개만 준비했다.
/api/normal: 별도 설정 없이 요청이 오면 1초간 sleep 후 응답한다./api/virtual: 동일한 동작을 하지만 Virtual Thread로 실행한다.
어떤 차이가 있을까?
테스트를 위해 ab -n 500 -c 500으로 각 엔드포인트를 부하 테스트해봤다.
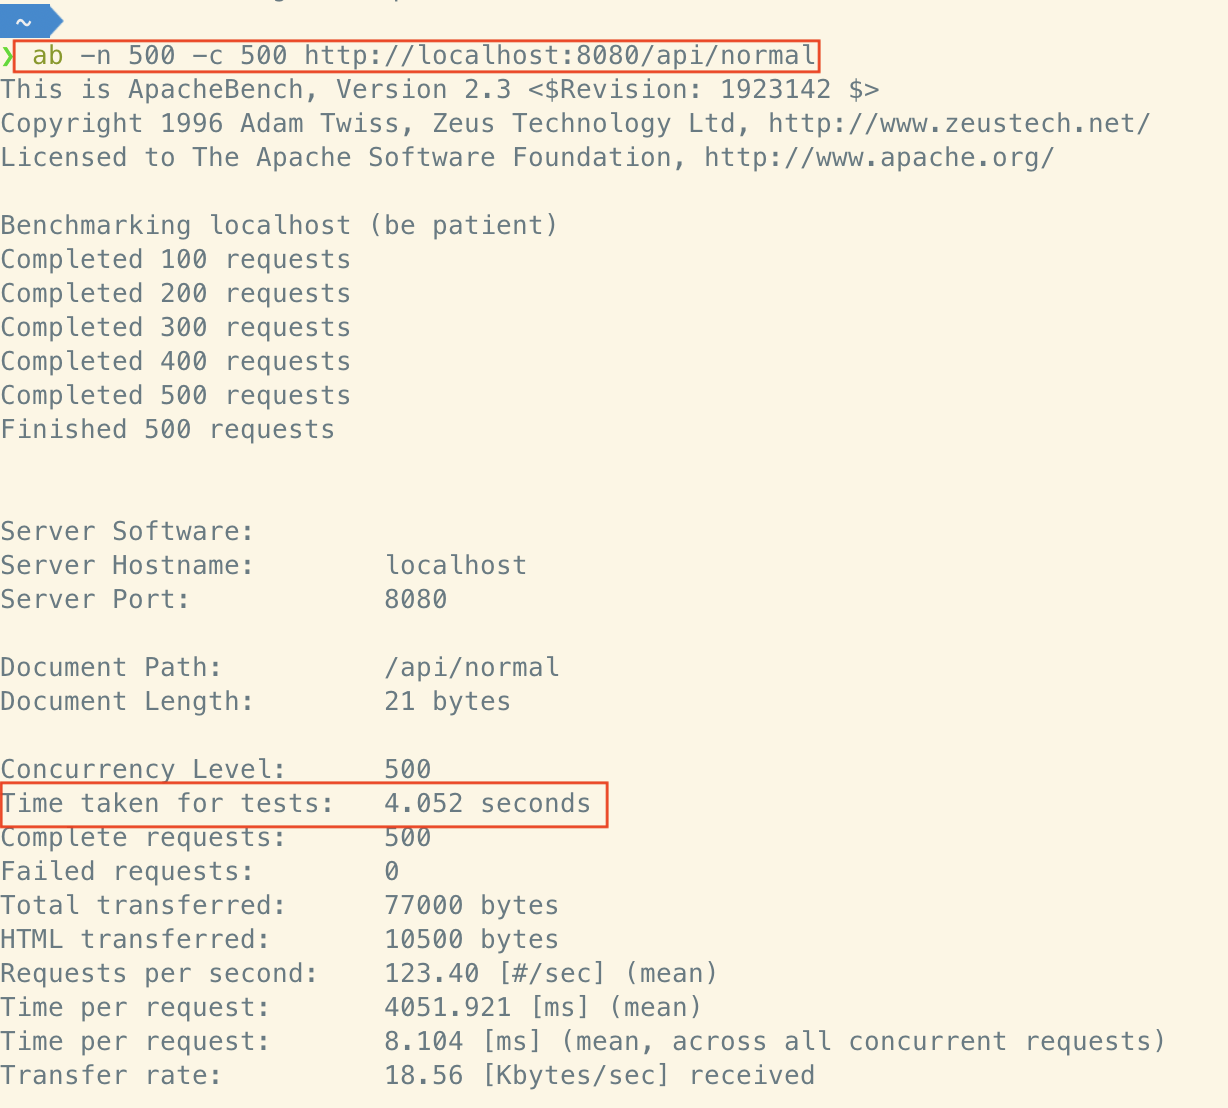
결과를 보면 200개가 응답을 받고 1초 쉬고, 다시 200개가 응답을 받는 식으로 총 4.052초가 걸린 것을 확인할 수 있다.
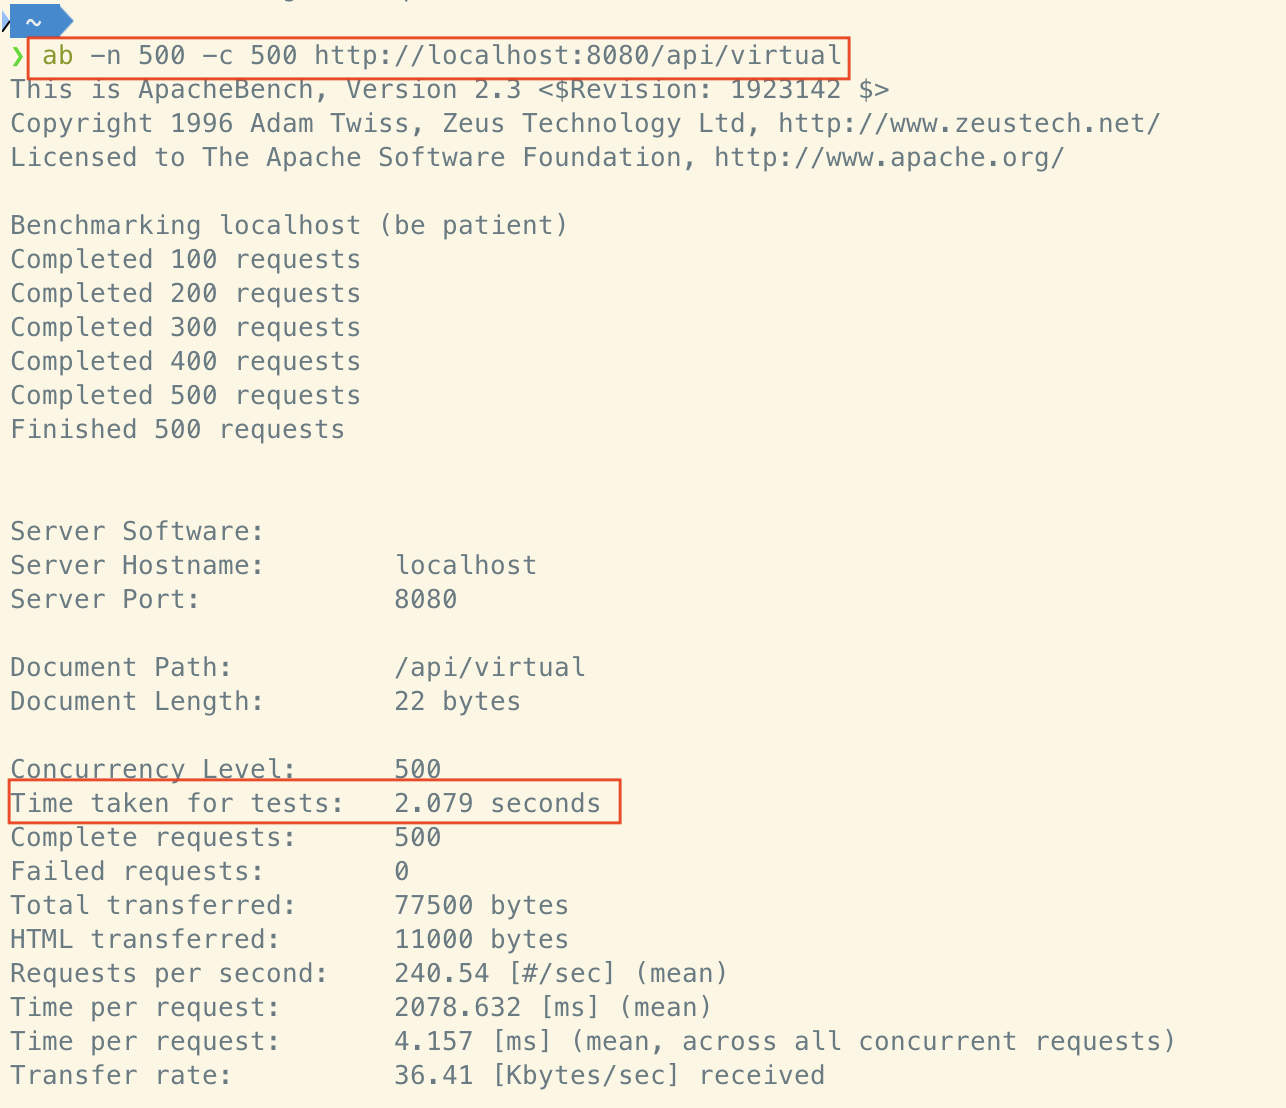
반면 virtual 엔드포인트는 한 번에 수행되어, 위 엔드포인트보다 훨씬 짧은 시간에 처리가 끝난 것을 확인할 수 있다.
기본적으로 Spring Boot 3.x 버전에서 application.yml의 Tomcat 스레드는 200개가 기본 할당된다.
1
2
3
4
server:
  tomcat:
    threads:
      max: 200
그래서 200개의 스레드가 전부 요청을 처리한 뒤 1초를 쉬고 나서야 다음 요청을 처리하는 방식으로 동작한 것이다.
Virtual Thread는 이와 다르게 요청이 올 때마다 새로 생성되기 때문에, 한 번에 처리된 것이다. 위에서 개념 설명 부분에서 언급했던 .yml 에 virtual thread 로만 변경 한다면 결과는 어떻게 될까?
1
2
3
4
5
# application.yml
spring:
  threads:
    virtual:
      enabled: true
당연하게도 /api/virtuals 엔드포인트와 동일한 결과를 낼것이다! (당연히 대규모 프로젝트에선 이렇게 쓰면 안된다. ㅎㅎ)
이상으로 Virtual Thread에 대해 공부해봤다. 실제로 Virtual Thread가 필요할 만큼 동시 요청 트래픽이 많은 환경에도 직접 적용해보고 싶다는 생각이 들었다.
사용법 자체도 간결하고, 기존 코드나 전체 의존성 구조를 크게 건드리지 않고도 상황에 맞게 도입할 수 있다는 점이 비교적 사용하기 편하다고 느껴졌다.