GraalVM — Java는 왜 느린가, 그리고 어떻게 빠르게 만드는가
배경
Lambda 환경에서 Java를 JVM에 얹어서 컨테이너로 사용한다고 가정하자.
호출 → JVM 빌드하는데 한세월.. Python 놔두고? Node 놔두고? 굳이 자바를?
그래도 난 자바를 쓰고싶어!!!!
>> GraalVM을 쓴다면 완벽하게 커버할 수 있다. 최적의 컴파일러이자 플랫폼
1. GraalVM이란?
GraalVM은 Oracle이 개발한 고성능 JDK이자 AOT 컴파일러다.
“Universal Virtual Machine”이라고도 불리며, Java/Kotlin/Scala 뿐 아니라 JavaScript, Python, Ruby, R, C/C++(LLVM) 등 다양한 언어를 하나의 VM 위에서 실행할 수 있다.
하지만 Java 개발자 입장에서 GraalVM을 주목해야 하는 이유는 두 가지다:
- Graal JIT Compiler — 기존 JVM JIT(C2)보다 더 공격적인 최적화
- Native Image (AOT) — JVM 없이 실행되는 네이티브 바이너리 생성
2. 왜 문제인가 — Java의 태생적 구조
JVM의 실행 흐름
1
Java Source → .class (Bytecode) → JVM 로딩 → Interpreter → JIT 컴파일 → 최적화된 기계어
Java가 처음부터 느린 게 아니다. 시작 순간부터 안정 상태(steady-state)까지의 과정이 문제다.
JVM 기동 시 실제로 일어나는 일
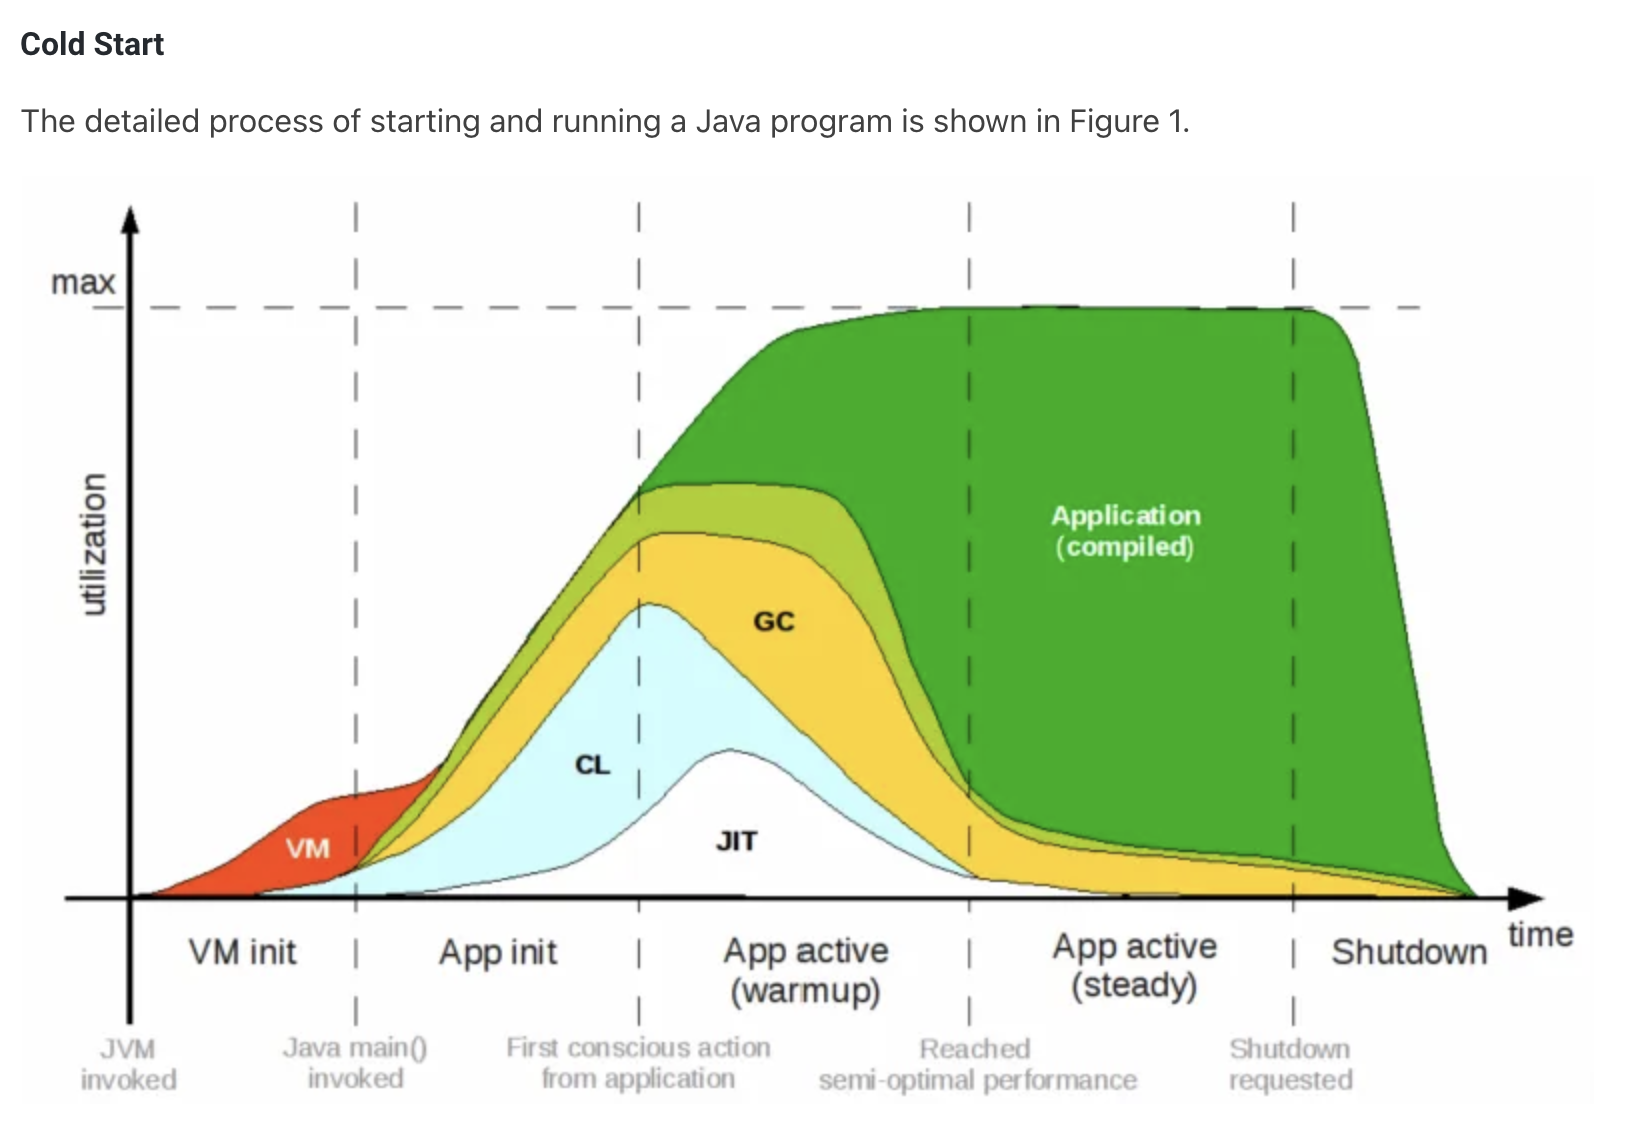
- JVM 프로세스 로딩 — JVM 자체를 메모리에 올린다
- Classloading — 필요한 클래스를 순차적으로 찾고, 검증하고, 메모리에 적재
- Bytecode Interpretation — 처음에는 JIT 없이 인터프리터로 한 줄씩 실행
- JIT Profiling — 얼마나 자주 호출되는지 추적(HotSpot 탐지)
- JIT Compilation (C1/C2) — 임계치를 넘어야 비로소 기계어로 컴파일
- Deoptimization 가능성 — 최적화 가정이 깨지면 다시 인터프리터로 roll-back
이 전체 과정에서 Warm-up이 발생한다. JVM은 충분히 실행된 후에야 진짜 성능을 낸다.
3. JIT 컴파일러의 두 단계 — C1과 C2
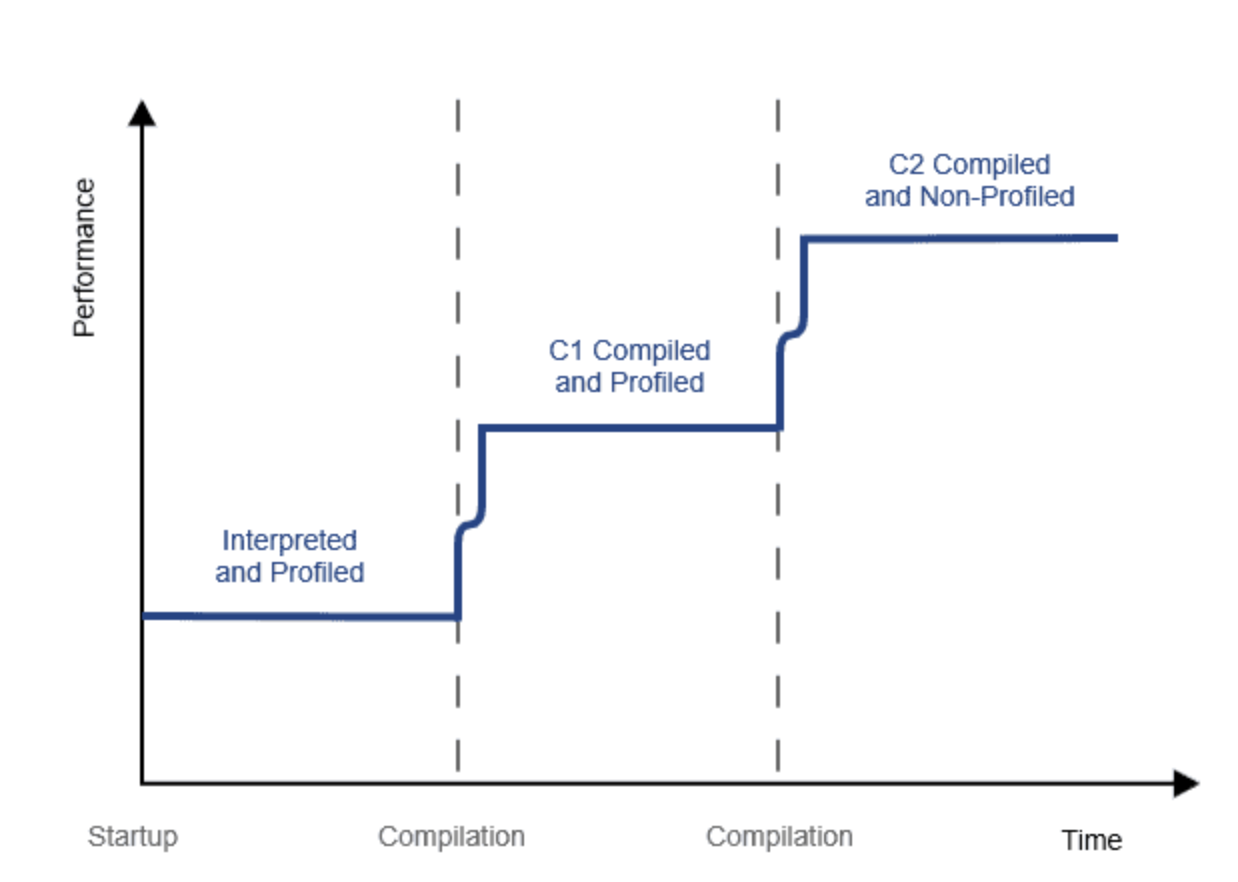
HotSpot JVM은 두 개의 JIT 컴파일러를 계층적으로(Tiered Compilation) 사용한다.
C1 (Client Compiler)
- 목적: 빠른 컴파일, 합리적인 성능
- 동작: 비교적 단순한 최적화만 수행. 컴파일 속도가 빠르다
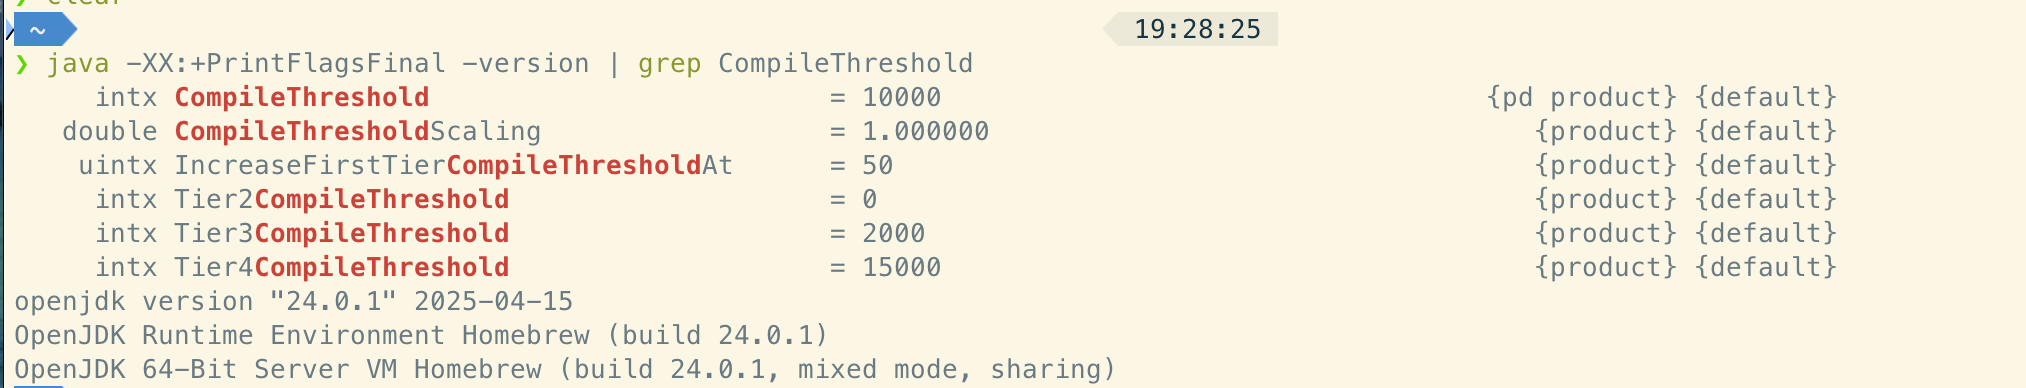
- 언제: 메서드 호출 횟수가 일정 임계치(기본 ~2,000회) 이상일 때
- 특징: 프로파일링 정보를 수집하면서 실행
C2 (Server Compiler)
- 목적: 최대 런타임 성능
- 동작: C++로 작성된 고도로 최적화된 컴파일러. Escape Analysis, Loop Unrolling, Inlining 등 공격적 최적화
- 언제: 더 많이 호출되는 Hot Method에 대해 (~10,000~15,000회)
- 특징: 컴파일에 시간이 걸리지만, 결과물은 매우 빠름
1
java -XX:+PrintFlagsFinal -version | grep CompileThreshold
1
2
3
4
5
Method 호출 횟수
0 ─────── ~2K ─────────── ~15K ─────────────────▶
[Interpreter]  [C1 컴파일]    [C2 최적화 컴파일]
                                     ↑
                            이 지점에서 비로소 Peak 성능
Graal Compiler (GraalVM JIT)
GraalVM은 C2를 Graal Compiler로 대체한다. Graal은 Java로 작성된 JIT 컴파일러로, C2보다 더 정교한 최적화가 가능하다 (C2는 C++로 작성됨). 뿐만 아니라:
더 깊은 인라이닝 (Aggressive Inlining)
메서드 호출을 없애서 기계어 명령어를 줄이는 최적화다.
메서드 호출 자체가 CPU 오버헤드(스택 프레임 생성, 컨텍스트 스위칭 등)를 발생시키므로, 호출할 메서드의 코드를 호출자 코드 안에 직접 삽입하는 방식이다.
원본 코드:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
public class User {
    private String name;
    private int age;

    public String getName() { return this.name; }
    public int getAge() { return this.age; }
}

public class UserService {
    public String formatUser(User user) {
        return formatName(user.getName()) + ", " + formatAge(user.getAge());
    }

    private String formatName(String name) { return name.toUpperCase(); }
    private String formatAge(int age) { return "Age: " + age; }
}

public void display(User user, UserService service) {
    System.out.println(service.formatUser(user));
}
C2 컴파일러의 인라이닝 (얕음):
1
2
3
4
5
6
7
8
9
public void display(User user, UserService service) {
    String name = user.getName();           // getName() 호출 유지
    String formatted = name.toUpperCase();  // formatName() 인라이닝

    int age = user.getAge();                // getAge() 호출 유지
    String ageStr = "Age: " + age;         // formatAge() 인라이닝

    System.out.println(formatted + ", " + ageStr);
}
Graal 컴파일러의 인라이닝 (깊음):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
public void display(User user, UserService service) {
    // user.getName() 인라이닝
    String name = user.name;

    // formatName(name).toUpperCase() 인라이닝
    String formatted = name.toUpperCase();

    // user.getAge() 인라이닝
    int age = user.age;

    // formatAge(age) 인라이닝
    String ageStr = "Age: " + age;

    System.out.println(formatted + ", " + ageStr);
    // 메서드 호출 4개 제거됨! (getName, getAge, formatName, formatAge)
}
성능 차이:
1
2
3
4
5
6
7
8
C2 결과:   display() → formatUser() → getName()
                                    → formatName()
                                    → getAge()
                                    → formatAge()
           총 4개의 메서드 호출 스택 생성

Graal 결과: display() [모든 로직 직접 포함]
            메서드 호출 제거! CPU 캐시 효율 ↑, 지연시간 ↓
BUT, 깊은 인라이닝일수록 메모리가 무거워진다. 메서드가 길면 하나하나 코드에 직접 박아야 되니 복제가 일어난다.
서버에서는 코드 캐시 오버플로우 발생 가능 및 성능에 비효율적이다.
더 정밀한 Escape Analysis → 힙 할당 감소
개념
객체가 생성된 메서드 밖으로 “탈출”하는지를 정적 분석해서, 탈출하지 않으면 스택에 할당하는 최적화다.
일반적으로 Java의 모든 객체는 힙에 할당되고 GC의 관리 대상이 된다. 하지만 메서드 내에서만 사용되는 객체라면 메서드 종료 시 자동으로 스택에서 제거되므로, 힙 할당과 GC 오버헤드를 피할 수 있다.
원본 코드:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
public class Point {
    private int x;
    private int y;

    public Point(int x, int y) { this.x = x; this.y = y; }
    public int getDistance() { return (int) Math.sqrt(x * x + y * y); }
}

// 케이스 1: 탈출하지 않음 (스택 할당 가능)
public int calculateDistance(int x, int y) {
    Point p = new Point(x, y);  // 로컬 객체
    return p.getDistance();     // 메서드 내에서만 사용
}

// 케이스 2: 탈출함 (힙 할당 필수)
public static Point globalPoint = null;
public void leakPoint(int x, int y) {
    Point p = new Point(x, y);
    globalPoint = p;  // 전역 변수에 저장 = 탈출!
}

// 케이스 3: 반환값으로 탈출
public Point createPoint(int x, int y) {
    Point p = new Point(x, y);
    return p;
}
C2 컴파일러의 분석 (보수적):
1
2
3
4
5
public int calculateDistance(int x, int y) {
    Point p = new Point(x, y);  // ← 힙에 할당 (안전성을 위해)
    return p.getDistance();
    // GC가 나중에 이 객체를 정리해야 함
}
Graal 컴파일러의 분석 (정밀):
1
2
3
4
5
6
7
8
9
10
public int calculateDistance(int x, int y) {
    // Point 객체를 힙이 아닌 스택에 직접 할당!
    int x_field = x;
    int y_field = y;
    // → "new Point()" 제거됨

    return (int) Math.sqrt(x_field * x_field + y_field * y_field);
    // 메서드 종료 시 자동으로 스택에서 제거
    // GC 오버헤드 0!
}
성능 차이:
1
2
3
4
5
6
7
8
9
C2 결과:
메모리 할당:  new Point() → 힙 메모리
메모리 해제:  GC가 나중에 정리
비용:         할당 + GC 비용

Graal 결과:
메모리 할당:  스택에 직접 할당 (매우 빠름!)
메모리 해제:  메서드 종료 시 자동 제거 (0 비용)
비용:         거의 없음 ↓↓↓
Partial Escape Analysis — 객체가 일부 경로에서만 탈출할 경우에도 스택 할당
개념
객체가 일부 실행 경로에서만 탈출하는 경우, 경로별로 다르게 최적화하는 기법이다.
조건문에 따라 객체가 탈출할 수도, 안 할 수도 있는 복잡한 상황에서, Graal은 각 경로를 분석해서 탈출하지 않는 경로에서는 스택 할당을 한다.
원본 코드:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
public class Calculator {
    private int value;
    public Calculator(int value) { this.value = value; }
    public int getValue() { return value; }
}

static Calculator globalCalc = null;

public void processNumber(int num, boolean shouldLeak) {
    Calculator calc = new Calculator(num);  // 객체 생성

    if (shouldLeak) {
        globalCalc = calc;  // ← 이 경로에서만 탈출!
        System.out.println("Global: " + calc.getValue());
    } else {
        System.out.println("Local: " + calc.getValue() * 2);  // ← 로컬 사용만
    }
}
C2 컴파일러의 처리 (불가능):
1
2
3
4
5
6
7
8
9
10
11
12
public void processNumber(int num, boolean shouldLeak) {
    Calculator calc = new Calculator(num);  // ← 항상 힙에 할당
    // (shouldLeak가 뭔지 정적으로 알 수 없으니 안전을 택함)

    if (shouldLeak) {
        globalCalc = calc;
        System.out.println("Global: " + calc.getValue());
    } else {
        System.out.println("Local: " + calc.getValue() * 2);
    }
    // 메서드 종료 → GC 실행
}
Graal 컴파일러의 처리 (경로별 최적화):
1
2
3
4
5
6
7
8
9
10
11
12
13
public void processNumber(int num, boolean shouldLeak) {
    if (shouldLeak) {
        // 경로 1: 탈출하므로 힙 할당 필요
        Calculator calc = new Calculator(num);  // ← 힙 할당
        globalCalc = calc;
        System.out.println("Global: " + calc.getValue());
    } else {
        // 경로 2: 탈출하지 않으므로 스택 할당!
        int value = num;  // ← 스택 변수
        System.out.println("Local: " + value * 2);
        // 메서드 종료 시 스택 변수가 자동 제거, GC 호출 안 함!
    }
}
성능 차이:
1
2
3
4
5
6
7
8
9
C2 결과:
모든 경로:  Calculator calc = new Calculator(num);  // 힙
            GC가 메서드 종료 후 정리

Graal 결과:
경로 1:    Calculator calc = new Calculator(num);  // 힙 (필요함)
경로 2:    int value = num;                        // 스택 (객체 생성 안 함)

이득:      shouldLeak == false 경로에서 GC 비용 완전 제거!
4. 핵심 개념 — AOT와 Native Image
JIT vs AOT
| JIT (Just-In-Time) | AOT (Ahead-Of-Time) | |
|---|---|---|
| 컴파일 시점 | 런타임 | 빌드 타임 |
| 초기 성능 | 느림 (warm-up 필요) | 즉시 최대 성능 |
| 피크 성능 | 매우 높음 (런타임 프로파일 기반) | 상대적으로 낮음 |
| 메모리 | JVM + 앱 메모리 | 앱 메모리만 |
| 시작 시간 | 수 초 | 수십 ms |
| 적합한 환경 | 장기 실행 서버 | Serverless, CLI, 마이크로서비스 |
Native Image가 하는 일
native-image 빌드 시 다음이 일어난다:
Points-to Analysis (정적 분석)
애플리케이션의 Entry Point(main)부터 도달 가능한 모든 코드 경로를 정적으로 추적.
사용되지 않는 클래스, 메서드는 완전히 제거된다 (Dead Code Elimination).Build-time Initialization 실행
static {}블록 등 초기화 코드를 빌드 타임에 미리 실행한다.
결과는 이미지에 frozen된 상태로 포함.Heap Snapshotting
빌드 타임에 생성된 객체 인스턴스들을 직렬화해 실행 파일의 Data Section에 직접 포함시킨다.
런타임 시 이 힙을 그대로 메모리에 매핑 → 클래스로딩, 초기화 시간 제로.Native 실행 파일 생성
JVM이 필요 없는 독립 바이너리 출력. Substrate VM이 최소한의 런타임(GC 등)을 포함.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
[빌드 타임]
 Java 소스 + 라이브러리
        ↓
 native-image 도구
  ├─ 정적 분석 (Points-to)
  ├─ Dead Code 제거
  ├─ 빌드타임 초기화 실행
  ├─ Heap Snapshot
  └─ AOT 컴파일
        ↓
 단일 실행 파일 (JVM 불필요)

[런타임]
 ./my-app → 즉시 실행 (ms 단위)
5. Lambda에서 Java가 불리한 이유, 그리고 Native Image
Serverless의 핵심 지표: Cold Start
Lambda, Cloud Functions, Azure Functions 같은 Serverless 환경에서는 함수가 일정 시간 호출되지 않으면 컨테이너가 내려간다. 다음 호출이 오면 새로 띄운다 — 이것이 Cold Start.
언어별 Cold Start 비교
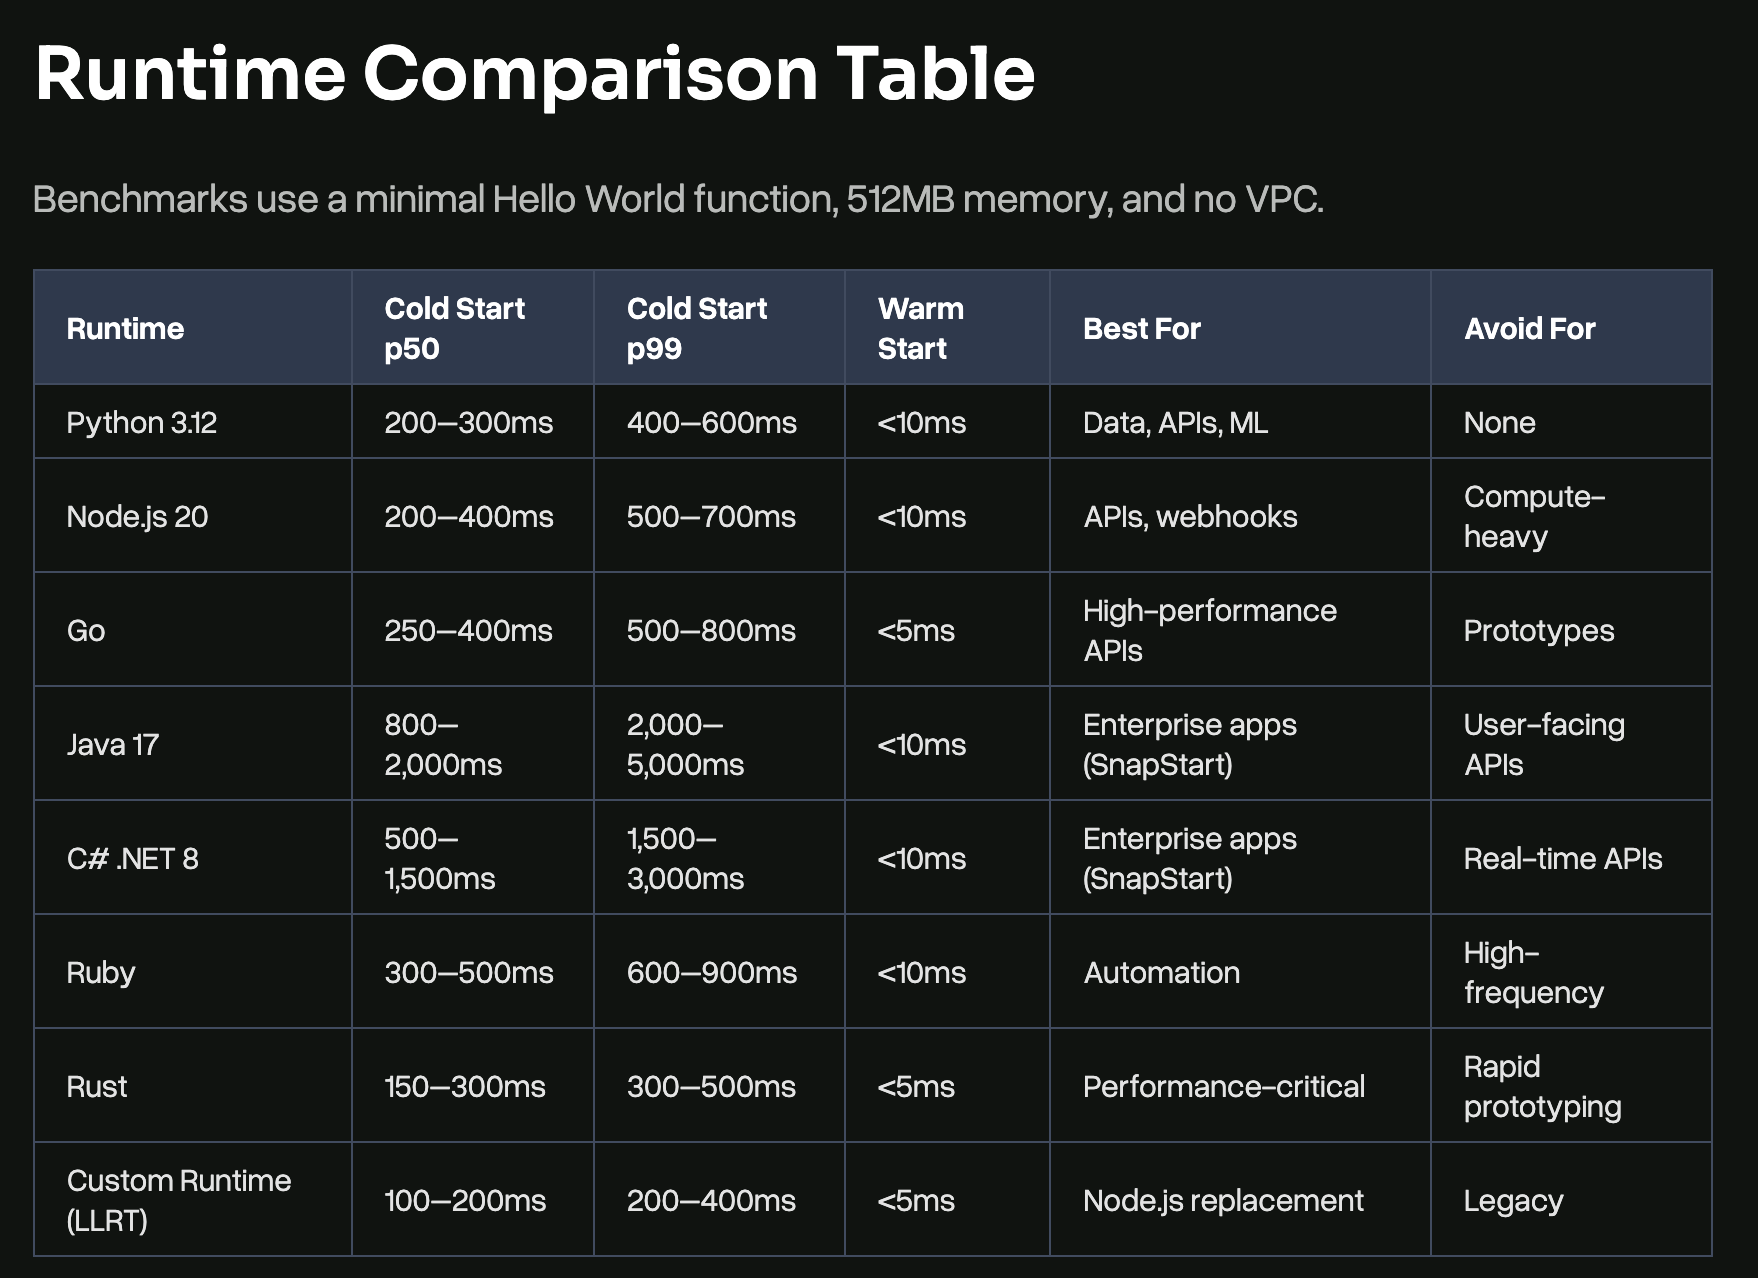 Java가 이렇게 느린 이유가 앞서 설명한 JVM 기동 절차 전체다.
Spring Boot 같은 프레임워크를 올리면 클래스로딩만 수천 개 클래스다. 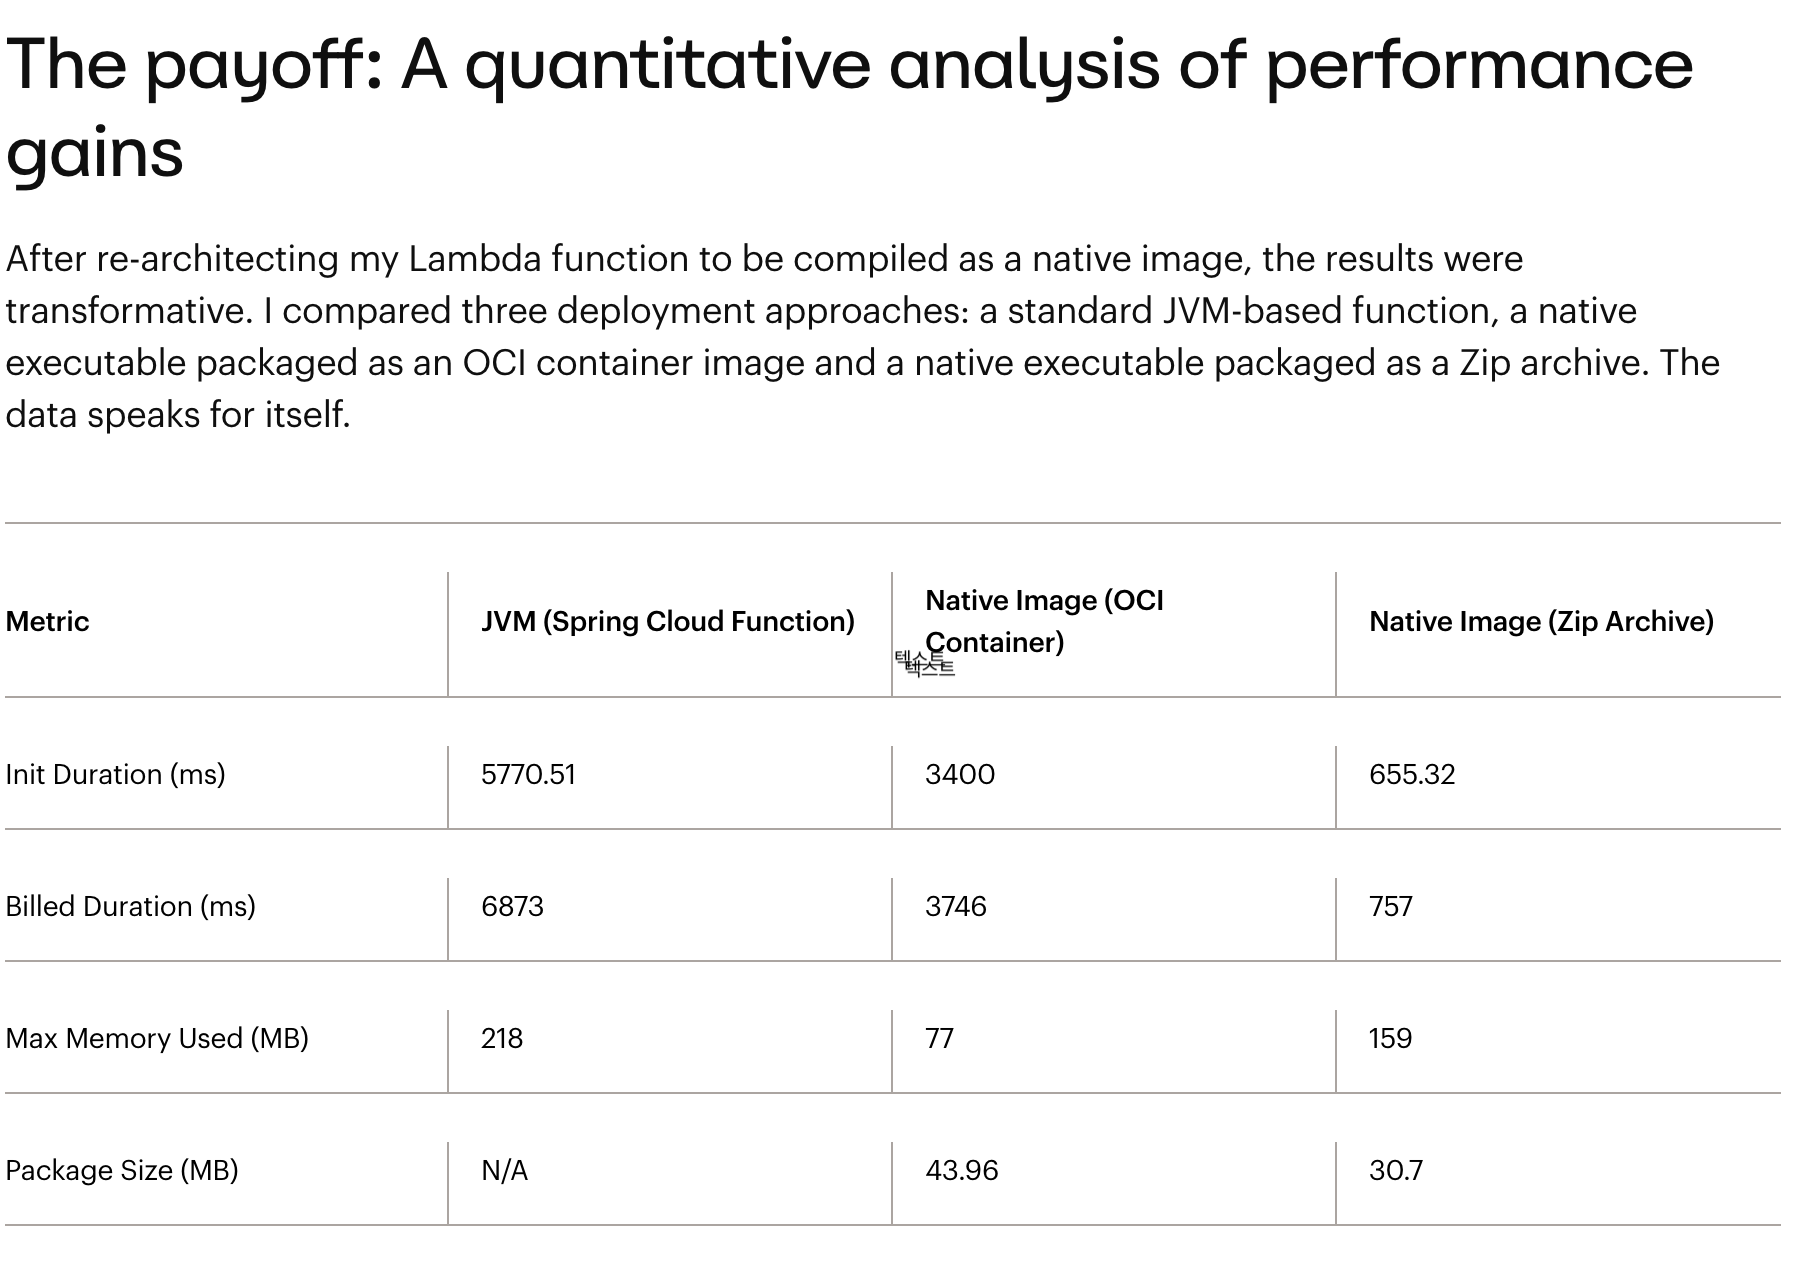
Native Image 적용 후
JVM vs. Native: The baseline JVM function had a cold start (Init Duration) of over 5.7 seconds. Simply compiling to a native executable and deploying as a Zip archive reduced this to just 655 ms — a staggering ~9x improvement.
Cold Start 약 9배 단축 (5.7초 → 655ms)
JVM은 기동 시 클래스로딩, 인터프리터 실행, JIT 프로파일링까지 전부 런타임에 처리한다.
Native Image는 이 과정을 빌드 타임에 끝냈기 때문에 실행하는 순간 바로 동작한다.
메모리 약 27% 절감 (218MB → 159MB)
JVM 모드는 JVM 자체 + JIT 컴파일러 + 코드캐시가 메모리를 점유한다.
Native Image는 JVM이 없고 앱에 필요한 코드만 포함된 단일 바이너리라 메모리 점유가 작다.
Lambda 비용에 직결
AWS Lambda는 메모리 × 실행시간으로 과금한다.
Cold Start가 줄면 Init Duration 과금이 줄고, 메모리가 줄면 단가 자체가 내려간다. 즉 성능 향상이 곧 비용 절감이다.
요렇게만 보면 Lambda를 쓸 때 JVM에 얹는 건 미련해 보인다.
6. 생태계 — GraalVM을 활용하는 프레임워크들 (Java로 작성)
Spring Native / Spring Boot 3 (AOT)
공식 문서: Spring Boot Native Image
- Spring Boot 3.0부터 공식 Native Image 지원 (2022년 11월)
./mvnw -Pnative spring-boot:build-image한 줄로 Native 컨테이너 빌드 가능- 기존 Spring 코드를 최대한 그대로 활용할 수 있도록 AOT Hints 시스템 제공
- 특징: 기존 Spring 개발자에게 가장 낮은 진입장벽. 그러나 Native 빌드 시간이 길고(수 분), 리플렉션 사용에 주의 필요
Quarkus (“Supersonic Subatomic Java”)
공식 문서: Quarkus Building Native Image
- Red Hat이 만든 처음부터 Native를 염두에 두고 설계된 프레임워크
- 빌드 타임 DI, 확장(Extension) 시스템으로 Native 호환성을 사전에 보장
- Dev Mode(
quarkus dev)로 빠른 개발 피드백 루프 제공- 특징: Native 최적화 수준이 높고 생태계가 성숙. Cloud Native 환경에 최적
Micronaut
공식 문서: Micronaut Building Native Images
- “Reflection-free” DI를 기본 설계 철학으로 삼은 프레임워크
- 컴파일 타임 DI 덕분에 Native 빌드 시 별도 설정이 거의 필요 없음
- AWS Lambda, GCP Cloud Functions 공식 통합 지원
- 특징: 리플렉션 문제를 구조적으로 회피. 가장 Native 친화적인 설계
Helidon
공식 문서: Helidon Native Image
- Oracle이 개발한 마이크로서비스 프레임워크 (GraalVM과 같은 회사)
- Helidon SE(리액티브), Helidon MP(MicroProfile) 두 가지 모드
- Oracle Cloud Infrastructure와의 통합에 강점
- 특징: GraalVM과 같은 Oracle 생태계. Native 지원이 안정적
7. 실제로 쓰는 곳이 있나? — 프로덕션 사례
참고: GraalVM at Twitter — Oracle Case Study GraalVM의 가장 유명한 사례. JIT 모드(Native 아닌 Graal JIT Compiler) 사용.
“코드 변경 없이 동일한 인프라에서 8~11% 성능 향상을 달성했다. 이는 일생에 한 번 있을까 말까 한 일이다.”
— Chris Thalinger, Staff Software Engineer, Twitter
- Tweet, Social, News 등 30~40개 핵심 마이크로서비스에 적용
- 같은 인프라에서 약 10% 더 많은 트래픽 처리 가능
- 서버 비용 절감으로 직결
Alibaba Cloud
참고: Performance Improvement by 10x — Alibaba Cloud
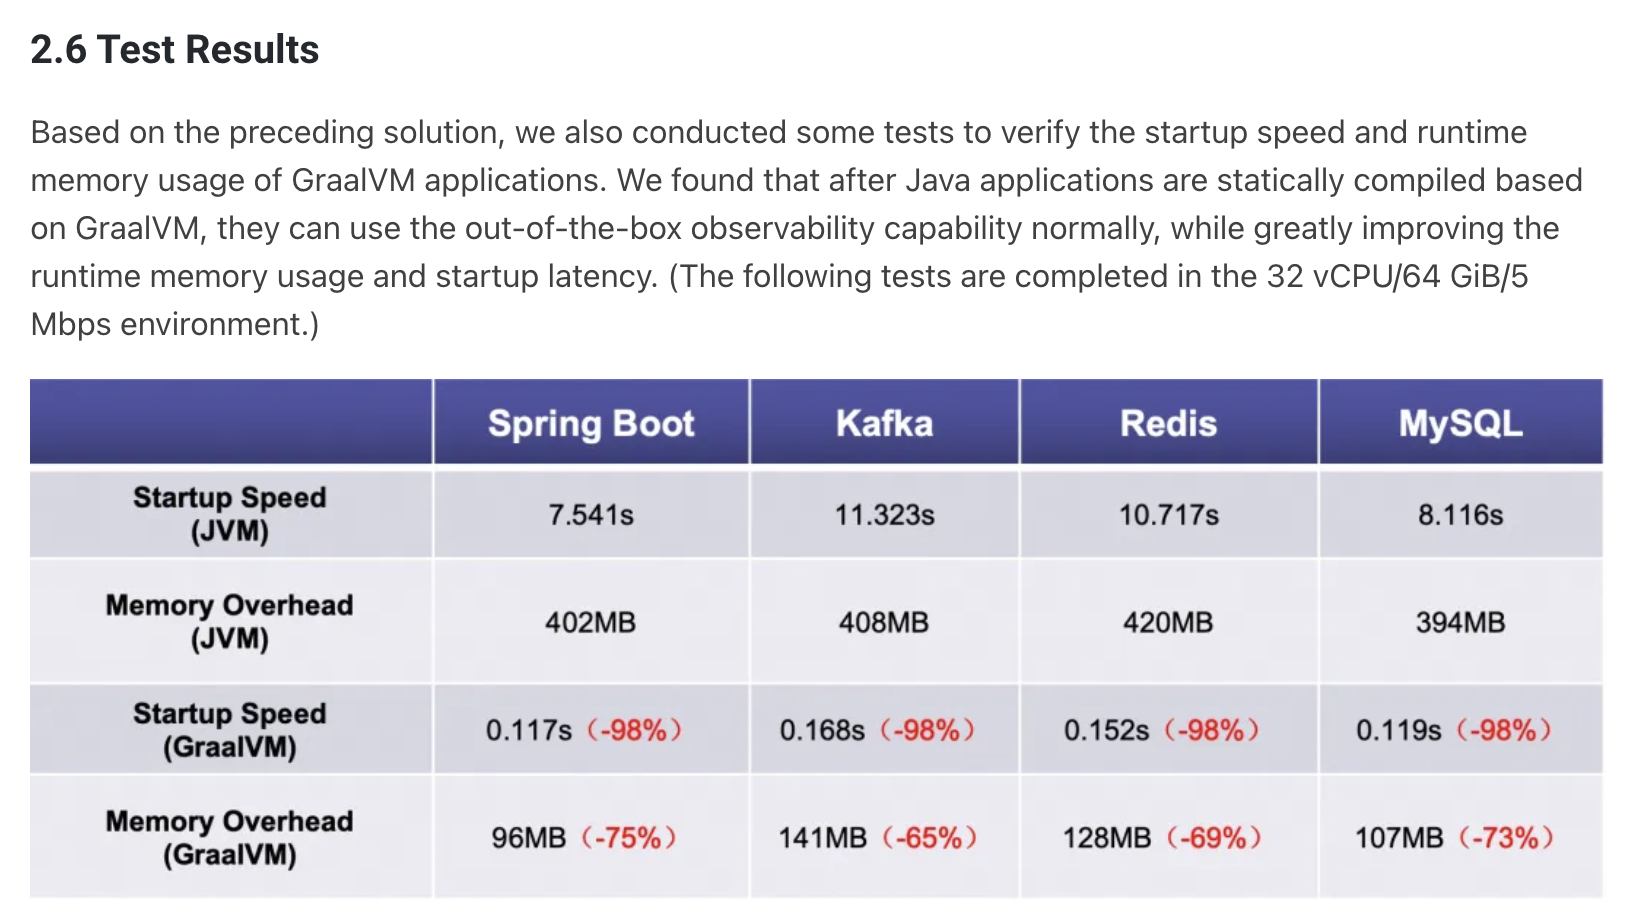
- Native Image를 Cloud Native 환경에 적용
- 특정 시나리오에서 10배 성능 향상 보고
- GraalVM JDK 개발에 직접 기여 (Contributor)
Facebook (Meta)
참고: GraalVM at Facebook — GraalVM Workshop 2021
- GraalVM JDK로 대규모 Java 애플리케이션 운영
- 성능 향상 및 리소스 사용량 감소 확인
AWS
참고: AWS SDK for Java — GraalVM Native Image
- AWS SDK for Java가 공식 Native Image 지원 (2022년 11월)
- Lambda에서 Java + GraalVM 조합을 공식 권장 패턴으로 인정
8. 제약과 트레이드오프
GraalVM Native Image가 Silver Bullet은 아니다. 반드시 고려해야 할 제약이 있다.
Closed World Assumption (닫힌 세계 가정)
정적 분석은 “빌드 타임에 알 수 있는 것만” 처리한다.
리플렉션:
Class.forName(),Method.invoke()등 동적 클래스 로딩은 사전에 메타데이터를 등록해야 함
"com.example.User 클래스가 필요하네?"→ 런타임에서만 알 수 있음동적 프록시: Spring AOP, Hibernate Proxy 등 런타임 프록시 생성 불가 (빌드 타임 대체 필요)
@Transactional같은 것들. 런타임에 프록시 객체를 만드는 것들classpath 스캐닝: 런타임 classpath 탐색 불가
@SpringBootApplication— 일반 JVM에서나 classpath나@Component등을 찾을 수 있음
→ Spring Boot 3, Quarkus, Micronaut은 이를 해결하기 위한 Hint/Extension 시스템을 제공하지만, 커스텀 라이브러리와의 통합에서 여전히 수동 작업이 필요한 경우가 있다.
빌드 시간
Native Image 빌드는 느리다. 보통 수 분(5~10분) 소요. 개발 Inner Loop에는 JVM 모드로, CI/CD에서만 Native 빌드를 권장한다.
Peak 처리량
JIT가 런타임 프로파일 기반으로 최적화하는 반면, AOT는 빌드 타임 정보만 활용한다.
장기 실행 고부하 서버에서는 JIT가 AOT보다 높은 피크 처리량을 낼 수 있다. (당연한 소리)
Native Image는 Profile-Guided Optimization으로 이를 일부 보완한다.
언제 Native가 맞는가
| 시나리오 | 권장 |
|---|---|
| Serverless / Lambda | ✅ Native Image 강력 권장 |
| 빠른 Scale-out이 필요한 마이크로서비스 | ✅ Native Image 유리 |
| CLI 도구 | ✅ Native Image 최적 |
| 장기 실행 모놀리스 / 배치 처리 | ✅ JVM (JIT가 더 유리) |
| 고처리량 레이턴시 민감 서비스 | ⚠️ 벤치마크 후 결정 |
9. 결론
GraalVM은 “Java가 느리다”는 인식에 정면으로 반박한다.
- JVM 모드에서도: Graal JIT이 C2를 대체해 코드 변경 없이 성능 향상
- Native Image: Serverless, 마이크로서비스 환경에서 Java를 Go/Rust급 시작 속도로
Java 생태계가 수십 년간 쌓아온 라이브러리, 도구, 개발자 경험을 그대로 유지하면서 Cloud Native 환경의 요구사항을 만족시킬 수 있다는 것 — 이게 GraalVM이 주는 가장 큰 가치다.
Spring Boot 3의 공식 Native 지원, AWS/GCP/Azure 모두의 SDK 지원, Twitter·Alibaba의 프로덕션 사례가 이를 증명한다.
Serverless에서 GraalVM 대신 JVM을 사용할 이유는 전혀 없다. 이건 트레이드오프가 아니라 필수다.